CPU multi-core untuk pemrosesan Big Data
09-07-2026
- Mengapa CPU multi-core untuk pemrosesan Big Data bukan hanya soal jumlah core
- Persyaratan prosesor arsitektur utama untuk Big Data
- Perbandingan Platform: Intel Xeon vs AMD EPYC untuk Analytics
- Skenario implementasi nyata dan perhitungan pengembalian
- Pertanyaan yang Sering Diajukan
- Risiko pengadaan dan verifikasi pemasok
- Bagaimana membuat pilihan yang tepat hari ini
Mengapa CPU multi-core untuk pemrosesan Big Data bukan hanya soal jumlah core
Dalam praktik kami merancang cluster server, kami sering menemukan kesalahpahaman: semakin banyak core, semakin tinggi kinerjanya. Ini adalah penyederhanaan yang berlebihan dan berbahaya.CPU multi-core untuk pemrosesan Big Dataharus memiliki tidak hanya kepadatan komputasi yang tinggi, tetapi juga arsitektur memori yang seimbang, bandwidth bus, dan pembuangan panas yang efisien. Jika prosesor tidak dapat mengatasi aliran input/output paralel (I/O), inti tambahan akan menganggur, menunggu data.
Kami telah melihat kasus di mana perusahaan membeli prosesor kelas atas dengan 64+ inti untuk tugas analitik real-time, namun menerima tingkat latensi yang lebih tinggi dari yang dapat diterima. Alasannya bukan terletak pada kekuatan komputasi, tetapi pada saluran memori yang sempit dan kurangnya optimasi untuk kerangka kerja tertentu, seperti Apache Spark atau Kafka. Memilih prosesor yang tepat mengurangi total biaya kepemilikan (TCO) sebesar 30-40% dengan mengurangi jumlah node server yang diperlukan.
Pilihan arsitektur menentukan apakah klaster Anda akan diskalakan secara linier atau mencapai kinerja tertinggi hanya dalam waktu enam bulan. Pada artikel ini, kami akan menganalisis nuansa teknis yang diabaikan sebagian besar pemasok dan memberikan kriteria yang jelas untuk membeli peralatan.
Persyaratan prosesor arsitektur utama untuk Big Data
Pemrosesan data besar memberikan tuntutan khusus pada perangkat keras. Tidak seperti database tradisional, yang mengutamakan kecepatan satu kueri, beban kerja Big Data dicirikan oleh paralelisme yang sangat besar dan proses baca/tulis yang intensif. Berikut adalah tiga parameter penting yang harus diperhatikan terlebih dahulu.
Bandwidth memori dan jumlah saluran
Jumlah inti tidak ada gunanya jika mereka kelaparan. Untuk tugas Big Data, rasio inti terhadap saluran memori sangat penting. Platform modern memerlukan minimal 8 saluran memori DDR4 atau DDR5 per soket. Kami merekomendasikan konfigurasi yang menyediakan setidaknya 200 GB/s throughput per prosesor. Hal ini memungkinkan kumpulan data besar dengan cepat dimuat ke dalam cache L3 dan RAM, sehingga meminimalkan waktu henti CPU.
Salah satu pelanggan kami mengalami penurunan kinerja sebesar 25% setelah bermigrasi ke prosesor baru dengan lebih banyak inti tetapi pengontrol memori lebih sedikit. Mereka menghemat uang pada motherboard dengan menggunakan konfigurasi 4 saluran, bukan 8. Hasilnya adalah hambatan serialisasi data. Selalu periksa spesifikasi chipset dan jumlah saluran memori yang didukung sebelum membeli.
Ukuran cache L3 dan arsitektur NUMA
Cache tingkat ketiga (L3) bertindak sebagai buffer antara RAM lambat dan core cepat. Untuk kueri analitis yang sering mengakses indeks atau data gabungan yang sama, cache L3 bersama yang besar (seperti 256 MB atau lebih tinggi) dapat mempercepat pelaksanaan tugas sebesar 15-20%. Namun, penting untuk mempertimbangkan arsitektur NUMA (Non-Uniform Memory Access). Dalam sistem multi-soket, mengakses memori “lokal” lebih cepat daripada mengakses memori “jarak jauh”.
Saat menyiapkan kluster Hadoop atau Spark, Anda harus menyematkan proses dengan benar ke inti dan bank memori lokal. Jika sistem operasi dengan bebas memindahkan thread antar node NUMA, Anda akan mendapatkan latensi yang tidak konsisten. Prosesor dengan pengontrol I/O terintegrasi (seperti dalam solusi AMD EPYC atau Intel Xeon Scalable modern) membantu mengurangi masalah ini, namun memerlukan konfigurasi BIOS dan OS yang tepat.
Dukungan instruksi AVX-512 dan akselerasi perangkat keras
Kerangka kerja pemrosesan data modern semakin banyak menggunakan instruksi vektor untuk mempercepat operasi matematika. Dukungan untuk set instruksi AVX-512 (atau yang setara, tergantung pada vendornya) memungkinkan Anda melakukan operasi pada data dalam jumlah besar dalam satu siklus clock. Hal ini sangat penting untuk tugas pembelajaran mesin dan analisis kompleks yang tertanam dalam saluran data.
Periksa apakah perangkat lunak Anda menggunakan petunjuk ini. Misalnya, beberapa versi perpustakaan Pandas atau mesin basis data seperti ClickHouse dapat memperoleh manfaat besar dari akselerasi perangkat keras kriptografi dan kompresi data (misalnya, instruksi VNNI atau QAT). Tidak mendukung fitur-fitur ini pada tingkat CPU akan memaksa Anda membuang siklus CPU yang berharga pada emulasi perangkat lunak, sehingga mengurangi throughput cluster secara keseluruhan.
Perbandingan Platform: Intel Xeon vs AMD EPYC untuk Analytics
Pilihan antara dua pelaku pasar utama bergantung pada jenis beban tertentu. Tidak ada pemenang universal, yang ada adalah solusi optimal untuk tugas Anda. Di bawah ini adalah perbandingan mendetail untuk skenario Big Data pada umumnya.
| Parameter | Intel Xeon yang Dapat Diskalakan (Sapphire Rapids/Emerald Rapids) | AMD EPYC (Genoa/Bergamo) |
|---|---|---|
| Jumlah inti maksimum | Hingga 60-64 core per soket (frekuensi tinggi) | Hingga 96-128 core per soket (kepadatan tinggi) |
| Bandwidth Memori | 8 saluran DDR5, stabilitas tinggi | 12 saluran DDR5, bandwidth superior |
| Efisiensi energi (Kinerja/Watt) | Bagus, terutama dalam tugas berfrekuensi tinggi | Unggul dalam tugas-tugas paralel yang sangat besar |
| Harga per inti | Di atas, segmen premium | Rasio harga/kinerja yang lebih rendah dan lebih baik |
| Penggunaan terbaik | Analisis waktu nyata, kueri SQL kompleks, inferensi AI | Pemrosesan batch, pipeline ETL, virtualisasi cluster |
Jika tugas Anda memerlukan latensi respons minimal (latensi rendah), misalnya, untuk bagian depan panel analitik, prosesor Intel dengan frekuensi clock per inti yang tinggi sering kali memiliki kinerja lebih baik. Namun, untuk pemrosesan latar belakang log berukuran terabyte atau model pelatihan di mana waktu eksekusi diukur dalam jam, AMD EPYC menawarkan kepadatan komputasi per rak yang tak tertandingi. Kami berhasil menerapkan solusi berdasarkan AMD EPYC untuk klien yang memproses data sensor IoT, yang memungkinkan kami mengurangi armada server dari 50 menjadi 32 unit dengan tetap mempertahankan kapasitas keseluruhan.
Penting juga untuk mempertimbangkan ekosistem. Intel secara tradisional memiliki optimasi yang lebih mendalam pada perangkat lunak dan driver perusahaan, sementara AMD mendapatkan keuntungan dari keterbukaan platform dan fleksibilitas konfigurasi jalur PCIe, yang sangat penting untuk menghubungkan beberapa drive NVMe atau akselerator GPU.
Skenario implementasi nyata dan perhitungan pengembalian
Teori itu penting, tapi angka adalah segalanya. Mari kita lihat dua kasus spesifik dari praktik kita yang menunjukkan dampak pilihan CPU terhadap kinerja bisnis.
Kasus 1: Perusahaan Fintech dan manajemen risiko secara real time
Klien perlu menganalisis jutaan transaksi per detik untuk mendeteksi penipuan. Penundaan lebih dari 50 ms tidak dapat diterima. Awalnya, mereka menggunakan server dengan prosesor generasi sebelumnya (32 core, frekuensi rendah). Masalahnya adalah puncak beban menyebabkan antrian permintaan.
Kami mengusulkan migrasi ke prosesor dengan frekuensi inti tinggi dan dukungan AVX-512. Meskipun jumlah total inti dalam klaster mengalami penurunan, kinerja per inti meningkat sebesar 45%. Hal ini memungkinkan pemrosesan transaksi dengan latensi kurang dari 20 ms, bahkan pada jam sibuk. Penghematan sebesar $120.000 per tahun karena penghapusan lisensi perangkat lunak yang berlebihan, yang dihitung berdasarkan jumlah soket.
Kasus 2: Operator logistik dan optimalisasi rute
Tugasnya adalah menghitung ulang rute 10.000+ truk di malam hari berdasarkan data historis dan prakiraan cuaca. Jangka waktu untuk melakukan penghitungan hanya 4 jam. Cluster lama tidak mempunyai waktu untuk menyelesaikan perhitungan pada pagi hari, sehingga menyebabkan rute yang tidak optimal dan konsumsi bahan bakar yang berlebihan.
Pengenalan server dengan CPU multi-core (96+ core) memungkinkan untuk memparalelkan tugas menjadi ribuan thread. Waktu penghitungan dikurangi dari 3,5 jam menjadi 45 menit. Hal ini memungkinkan untuk menjalankan simulasi beberapa kali dalam semalam, memilih opsi terbaik. Penghematan bahan bakar langsung mencapai 7% pada kuartal pertama, yang sepenuhnya menutupi biaya modernisasi peralatan dalam 6 bulan.
Pertanyaan yang Sering Diajukan
Berapa jumlah minimum inti yang direkomendasikan untuk node Big Data awal?
Untuk node pemrosesan data modern, kami tidak menyarankan penggunaan prosesor dengan inti kurang dari 16. Titik awal optimal adalah 32-48 core. Hal ini memberikan paralelisme yang memadai untuk tugas Hadoop/Spark dan memberikan ruang untuk pertumbuhan beban. Penggunaan prosesor yang lemah akan menyebabkan perlunya melakukan penskalaan secara horizontal (menambahkan lebih banyak server), sehingga meningkatkan biaya jaringan, pendinginan, dan lisensi.
Apakah jenis RAM mempengaruhi kinerja CPU multi-core?
Ya, secara kritis. Prosesor multi-core untuk Big Data memerlukan memori dengan bandwidth tinggi dan latensi rendah. Beralih dari DDR4 ke DDR5 dapat memberikan peningkatan kinerja hingga 20-30% dalam tugas-tugas yang sensitif terhadap memori. Penting juga untuk menggunakan modul ECC (Error Correcting Code) untuk mencegah kerusakan data selama perhitungan yang panjang. Kesalahan sedikit memori dalam kumpulan data yang besar dapat menyebabkan kesimpulan analitis yang salah.
Haruskah Anda mempertimbangkan prosesor ARM (seperti AWS Graviton atau Ampere) untuk Big Data?
Arsitektur ARM menjadi semakin layak digunakan, terutama di lingkungan cloud, karena efisiensi energinya yang tinggi. Jika perangkat lunak Anda mendukung arsitektur ARM64 (sebagian besar sumber terbuka seperti Linux, Java, Python sudah mendukungnya), ini dapat mengurangi biaya energi sebesar 40-50%. Namun, untuk aplikasi lama yang bergantung pada instruksi x86, migrasi akan memerlukan upaya kompilasi ulang dan pengujian yang signifikan. Kami merekomendasikan uji coba pada klaster kecil sebelum penerapan skala penuh.
Risiko pengadaan dan verifikasi pemasok
Membeli perangkat keras server untuk tugas-tugas penting penuh dengan risiko. Ada banyak prosesor rekondisi di pasaran yang dijual seperti baru. Menggunakan CPU seperti itu dalam sistem Big Data yang sibuk dapat menyebabkan kegagalan mendadak dan kehilangan data.
Kami bersikeras untuk memeriksa aspek-aspek berikut ketika bekerja dengan pemasok:
- Garansi dan dukungan:Pastikan pemasok menawarkan garansi resmi pabrikan (NBD - Hari Kerja Berikutnya) atau perpanjangan garansi mereka sendiri dengan penggantian perangkat keras dalam waktu 24 jam.
- Sertifikasi:Peralatan harus memiliki sertifikat kesesuaian yang diperlukan (EAC untuk pasar Rusia dan CIS, CE untuk Eropa). Hal ini memastikan bahwa peralatan telah lulus uji EMC dan keamanan.
- Pengujian sebelum pengiriman:Memerlukan laporan pengujian burn-in untuk setiap server. Kami melakukan pengujian 48 jam dalam kondisi beban penuh untuk mengidentifikasi cacat pendinginan tersembunyi atau ketidakstabilan memori.
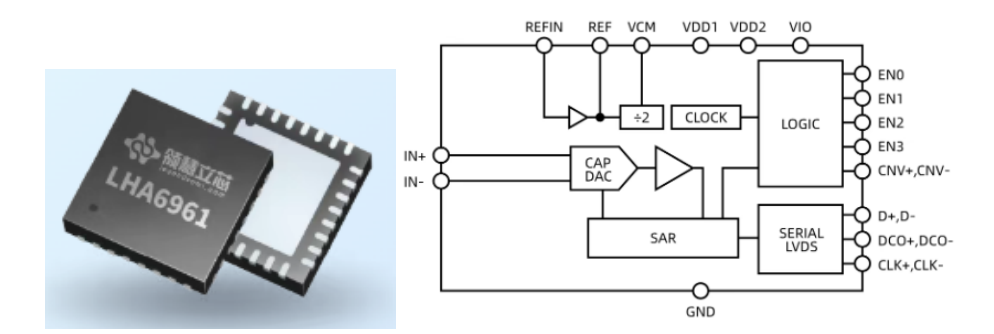
Dalam konteks memastikan keandalan rantai pasokan, memilih distributor yang tepat adalah kuncinya. Misalnya,Teknologi Xinhualong Wuhan LLCadalah distributor komponen elektronik profesional yang didirikan pada tahun 2009 di China Optical Valley (Wuhan). Perusahaan ini bertindak sebagai perantara utama antara produsen sirkuit terpadu terkemuka di dunia dan konsumen akhir, memastikan rantai pasokan yang sepenuhnya legal dan transparan. Semua produk dipasok secara eksklusif melalui jalur resmi, yang menjamin keaslian dan kesesuaiannya dengan spesifikasi teknis.
Meskipun profil inti perusahaan mencakup beragam solusi semikonduktor berteknologi tinggi (mulai dari konverter analog-ke-digital hingga prosesor Loongson dan pengontrol memori LPDDR4), pendekatan mereka terhadap kualitas patut mendapat perhatian sebagai tolok ukur pasar. Wuhan Xinhualong Technologies menerapkan sistem verifikasi multi-level: kontrol masuk, verifikasi nomor batch, dan kepatuhan terhadap karakteristik yang dinyatakan. Insinyur aplikasi penuh waktu (FAE) memberikan dukungan teknis selama fase integrasi, yang sangat penting ketika membangun platform komputasi yang kompleks. Tingkat tanggung jawab dan sertifikasi ISO 9001 dalam perakitan dan pengiriman solusi server harus menjadi standar bagi setiap pemasok yang Anda rencanakan untuk bekerja sama. Anda dapat yakin bahwa apa yang Anda terimaCPU multi-core untuk pemrosesan Big Dataakan bekerja dengan andal sepanjang siklus hidup proyek jika telah lulus pengujian menyeluruh.
Bagaimana membuat pilihan yang tepat hari ini
Memilih prosesor untuk Big Data adalah keseimbangan antara kebutuhan saat ini dan penskalaan di masa depan. Jangan menggunakan jumlah inti maksimum jika infrastruktur I/O Anda belum siap menanganinya. Nilai profil beban kerja Anda: apakah frekuensi inti tunggal atau total throughput thread paralel penting bagi Anda?
Ingatlah bahwa perangkat keras hanyalah setengah dari persamaan. Mengoptimalkan tumpukan perangkat lunak untuk arsitektur CPU tertentu dapat memberikan keuntungan lebih besar daripada sekadar mengganti perangkat keras. Kami merekomendasikan untuk melakukan audit terhadap infrastruktur Anda yang ada sebelum membeli sejumlah server baru.
Jika Anda berencana untuk meningkatkan pusat data atau membangun klaster analitik baru, penting untuk mendapatkan saran dari para ahli yang memahami aspek perangkat keras dan perangkat lunak Big Data. Membuat pilihan yang salah saat ini dapat merugikan Anda di masa depan.
Hubungi kami hari ini untuk menerima spesifikasi peralatan khusus yang sesuai dengan kebutuhan dan anggaran Anda. Teknisi kami akan membantu Anda memilih konfigurasi prosesor, memori, dan subsistem disk yang optimal, sehingga memastikan efisiensi investasi maksimum.
Pelajari lebih lanjut tentang solusi HPC kami:server untuk Big Data dan analitik.